
Data Lake или Data Warehouse и роль ETL. Есть ли ещё смысл создавать собственный ETL?
Концепция больших данных (Big Data) существует уже давно, но многие до сих пор не знают, как правильно их структурировать и хранить. Разберёмся, чем Data Lake отличается от Data Warehouse и что такое ETL.
Data Lake или Data Warehouse
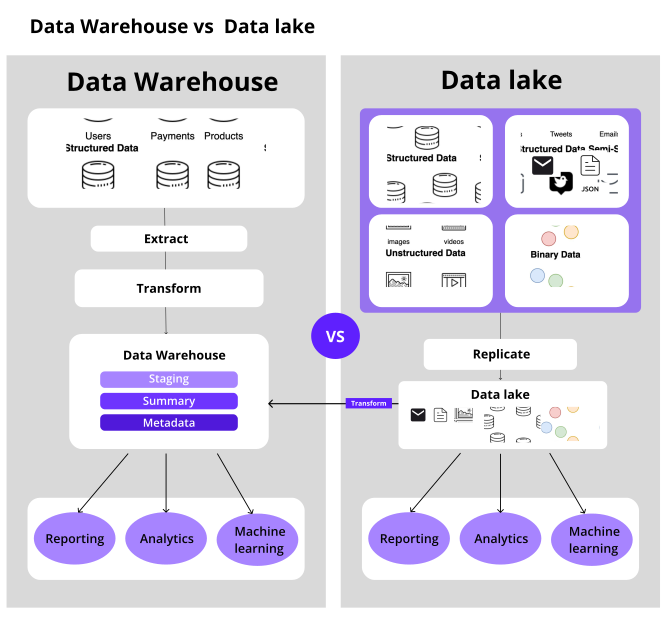
И Data Lake, и Data Warehouse служат для объединения множества источников данных, но у них разное назначение и разная архитектура.
Хранилище данных (Data Warehouse, DWH) — это система, которая сводит данные из разных источников в единое централизованное и согласованное хранилище. Её главная задача — поддерживать анализ данных, интеллектуальный анализ данных (data mining), искусственный интеллект и машинное обучение и вмещать большие объёмы данных из всех подразделений организации. Озеро данных (Data Lake), напротив, предлагает альтернативный подход к хранению и обработке больших объёмов данных. В отличие от Data Warehouse, где данные заранее структурированы в реляционной модели и следуют заданной схеме, в Data Lake можно хранить данные любого типа — структурированные (например, таблицы реляционных баз данных и файлы Excel), полуструктурированные (например, файлы XML или JSON, веб-страницы) и неструктурированные (включая изображения, аудиофайлы и публикации в социальных сетях). Такой подход сохраняет сырые данные без предварительной обработки и даёт гибкость для последующего анализа.
Что такое ETL?
ETL (Extract, Transform, Load — извлечение, преобразование, загрузка) — это процесс интеграции данных: данные извлекаются из разных источников, приводятся к единому формату и загружаются в Data Warehouse для анализа и отчётности.
Источники данных для ETL бывают самыми разными:
Базы данных: SQL-серверы, Oracle, MySQL, MongoDB. CRM-системы: Salesforce, HubSpot. Файлы CSV, Excel, XML. Веб-сервисы: API, веб-скрейпинг.
Процесс ETL:
- Шаг 1 — извлечение
- Шаг 2 — преобразование
- Шаг 3 — загрузка
Разберём процесс ETL на примере розничной компании:
- Извлечение: всё начинается с получения данных из разных CRM-систем, включая информацию о клиентах — имена, адреса электронной почты, даты последних покупок и потраченные суммы.
- Преобразование: на этом этапе данные стандартизируются. Например, имена переводятся в верхний регистр, адреса электронной почты — в нижний, даты приводятся к формату DD-MM-YYYY, а суммы отображаются с двумя знаками после запятой. Как именно преобразовывать данные, определяют бизнес-правила: например, отфильтровать записи, не отвечающие определённым критериям, или объединить данные из разных источников.
- Загрузка: наконец, данные загружаются в озеро данных компании с расчётом на ежедневное обновление. В результате компания получает чистые стандартизированные данные, которые можно использовать для анализа покупок и планирования маркетинговых кампаний.
Рестораны и кафе могут с помощью ETL-процессов оптимизировать доставку, объединяя данные из разных источников, например с собственных сайтов и платформ доставки. Это помогает эффективно управлять курьерами, сокращать время доставки и улучшать клиентский опыт.
Альтернативный подход — ELT (Extract, Load, Transform): данные сначала извлекаются, затем загружаются в Data Lake и уже потом преобразуются в нужный формат.
Популярные современные ETL-инструменты на рынке
Эти инструменты позволяют отслеживать рабочие процессы, а также обеспечивают интеграцию данных, контроль их качества и управление мастер-данными.
- Airflow
- Airbyte
- DBT
- Prefect
Почему компаниям необходим собственный ETL:
Собственные ETL-решения могут понадобиться компаниям, когда:
- У них есть уникальные источники данных или требования к интеграции, которым не отвечают готовые ETL-инструменты.
- Им нужен полный контроль над процессом ETL, включая качество данных, логику преобразования и обработку ошибок.
- У них высокие требования к безопасности и соответствию нормативам, которые не могут выполнить облачные ETL-инструменты.
- Им нужно расширить или доработать существующие ETL-конвейеры.
Есть ли ещё смысл создавать собственный ETL
Безусловно. Предлагая услуги ETL, мы помогаем клиентам не только объединять данные из разных источников, но и обеспечивать их высокое качество, что критически важно для принятия обоснованных бизнес-решений. При таком разнообразии источников данных и требований к обработке ETL остаётся важнейшим инструментом в арсенале бизнеса для эффективной аналитики и поддержки стратегических инициатив.
Нужна помощь в создании хранилища данных? Воспользуйтесь экспертизой CODECAVE
CODECAVE — поставщик IT-услуг с широкой технической экспертизой: аналитика больших данных, data science, ИИ и машинное обучение, облачные решения, разработка собственных плагинов для Autodesk AutoCAD®, Revit®, интерактивная 3D-визуализация, захватывающие AR- и VR-решения, DevOps и многое другое. Наша команда разработчиков создаёт решения для компаний из финтеха, ритейла, пищевой промышленности, медиа, автомобильной отрасли, здравоохранения и других сфер. Мы помогаем многим клиентам использовать их хранилища и озёра данных, справляться с большими данными, улучшать бизнес-аналитику и извлекать из всего этого максимальную пользу.
Например, в рамках сотрудничества с итальянской компанией из сферы общественного питания (под NDA) команда CODECAVE создала хранилище данных для хранения и обработки значительных объёмов информации. Команда внедрила систему категоризации данных на основе машинного обучения. Это позволило загружать данные в хранилище по разделам. Благодаря хранилищу компания своевременно получает отчёты, а сама система служит основой для операционных процессов.
Если у вас есть вопросы о процессе ETL или его ценности для вашего бизнеса, свяжитесь с нашей командой, чтобы получить бесплатную консультацию.